NAS 内存与 SSD 缓存升级:什么时候值得加,什么时候是浪费

内存:NAS 里最被低估的部件
NAS 里的内存有三个用途,重要程度依次递减:
第一,充当磁盘缓存。 这是最关键的。操作系统会把空闲内存拿来缓存最近读过的文件数据(Linux 的 page cache、ZFS 的 ARC、Btrfs 也有类似机制)。内存越大,热点数据的命中率越高,重复访问就越少碰机械盘。
这个机制解释了一个常见现象:同一台 NAS,第一次打开相册很慢,第二次再打开就飞快。第一次是从硬盘读,第二次是从内存读。
第二,给应用和容器用。 每个 Docker 容器、每个虚拟机、每个索引服务都要占内存。相册的 AI 识别、全文检索的索引构建,都是内存消耗大户。内存不够时会触发交换(swap),一旦开始用硬盘当内存,性能会断崖式下降。
第三,转码和传输缓冲。 视频转码时帧数据在内存里处理,大文件传输也需要缓冲区。
多大内存才够
| 使用场景 | 建议内存 |
|---|---|
| 纯 SMB/NFS 文件共享、下载机 | 2–4 GB |
| 文件共享 + 相册索引 + 两三个容器 | 8 GB |
| 五到十个容器 + 相册 + 影音转码 | 16 GB |
| 一两个虚拟机 + 多容器 | 16–32 GB |
| TrueNAS / ZFS(含去重或大量数据集) | 8 GB 起步,16–32 GB 舒适 |
| Proxmox 跑多虚拟机 | 32 GB 起 |
一个判断方法:进入 NAS 的资源监控页面,看内存的“缓存/缓冲”占用。如果可用内存长期接近于零、swap 有使用量,就该加了。反之,如果空闲内存常年剩一大半,加内存不会有任何感觉。
ECC:要不要为了它换平台
ECC(Error-Correcting Code)内存能检测并纠正单比特错误。对 NAS 的意义在于:
- 长时间运行:内存位翻转的概率随运行时间累积。7×24 开机一年以上的设备,出现单比特错误的概率不可忽略。
- ZFS 的特殊性:ZFS 在内存中维护校验和树,如果内存中的数据本身出错了,写入磁盘的就是错误数据且校验和也会“正确地”匹配这个错误——这就破坏了 ZFS 的数据完整性保证。因此 ZFS 社区强烈推荐 ECC。
- 非 ZFS 系统:ext4、Btrfs 同样受益于 ECC,但风险相对低一些。
现实情况是,主流 NAS 的 CPU 平台支持 ECC 的并不多:
- 群晖 DS925+ 的 Ryzen V1500B 支持 ECC(预装的就是 DDR4 ECC SODIMM)
- 铁威马 F4-424 Pro 明确标注 DDR5 non-ECC
- 极空间 Z4Pro、绿联 DXP4800 Plus、威联通 TS-464 均未标称 ECC
所以如果你非常看重 ECC,可选范围其实很窄:群晖的部分机型,或者自己 DIY 选支持 ECC 的主板 + CPU。
升级内存的注意事项
- 查兼容列表。 群晖和威联通都明确建议使用原厂内存模块,用第三方可能导致性能下降、报错甚至无法启动。这不是纯营销——NAS 对内存稳定性确实敏感。
- 双通道与同规格。 两条内存的容量、频率、时序最好一致,混插可能降频运行。
- 注意插槽数量和上限。 铁威马 F4-424 Pro 只有一个插槽且已预装 32 GB,等于没有升级空间;绿联 DXP4800 Plus 两个插槽可到 64 GB;群晖 DS925+ 两个插槽最大 32 GB。买之前先查清楚。
- 拆机有风险。 部分机型拆机可能影响保修,动手前确认保修条款。
- 升级后要验证。 开机进系统确认识别到全部容量,跑一次内存测试(如 memtest86+)更稳妥。
SSD 缓存:先分清三种形态
很多人说的“加 SSD 缓存”其实指三种完全不同的东西:
形态一:只读缓存(Read Cache / L2ARC)
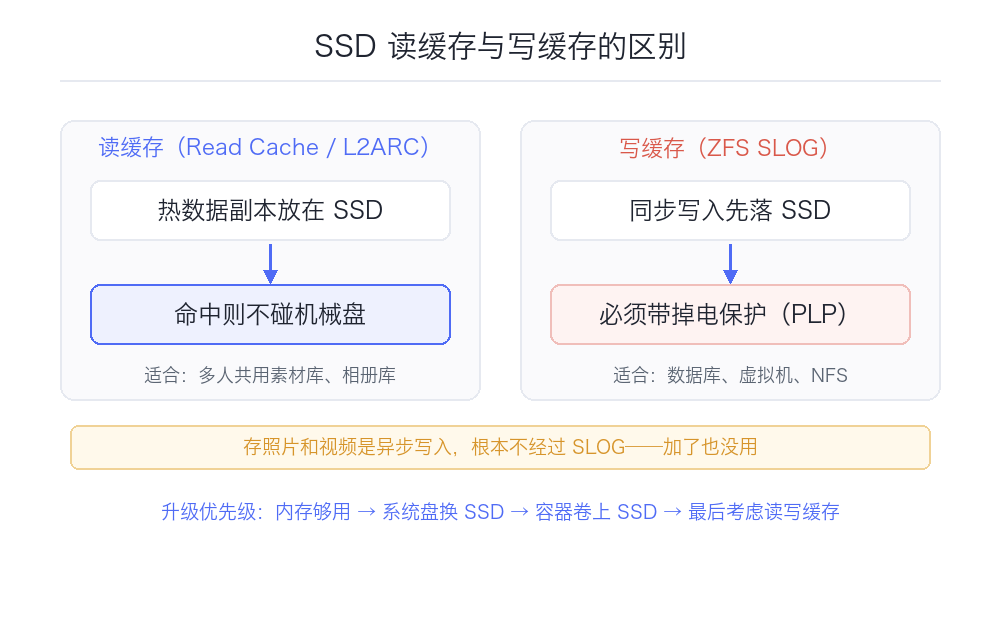
把热点数据复制到 SSD 上,读取时先查 SSD。
适合: 有大量文件被反复读取的场景——比如多人共用的素材库、经常访问的照片库、数据库索引。
不适合: 一次性读取的大文件(电影、备份归档)。数据第一次读时本来就不在缓存里,缓存命中率为零,加了完全没用。
形态二:写入缓存 / SLOG(Separate Intent Log)
ZFS 的概念。同步写入(数据库、虚拟机、NFS、iSCSI 这类要求“写入必须落盘才返回”的操作)先写到 SSD 上,再异步刷入机械盘。
关键点:SLOG 设备必须用带掉电保护(PLP)的 SSD。 否则断电时 SSD 里的数据会丢失,而系统已经告诉应用“写入成功”,结果是数据不一致——比不加 SLOG 更糟。
消费级 NVMe 绝大多数没有掉电保护电容,不适合做 SLOG。企业级 SSD(如带 PLP 的 Intel/Samsung PM 系列)才行。
如果你只是存照片和视频,SLOG 完全没必要。 因为普通文件拷贝是异步写入,走的是内存缓冲,根本不经过 SLOG。
形态三:缓存池(Cache Pool,Unraid 的做法)
所有新写入先落到 SSD 缓存池,后台再定期搬到机械盘阵列。
好处: 写入速度快、机械盘可以停转省电、Docker 和虚拟机跑在 SSD 上非常流畅。
风险: 缓存池在搬移前是单点。如果缓存盘坏了、且数据还没搬到阵列,那部分数据会丢。解决办法是用两块 SSD 组 RAID 1 缓存池。
什么时候加缓存有用,什么时候白花钱
会明显受益的场景:
- 多人同时访问同一批文件(读缓存命中率高)
- 运行数据库、虚拟机镜像(随机小 IO 密集)
- 相册/全文检索的索引所在卷
- Docker 容器和虚拟机的数据卷
- 元数据密集型操作(大量小文件的目录遍历、rsync 增量同步)
几乎没用的场景:
- 家庭影音库(大文件顺序读取,机械盘本来就快,且看过一次不会反复看)
- 冷备份归档(写入后基本不读)
- 单用户偶尔拷贝文件
- 网络本身就是瓶颈(速度卡在千兆网口上,加缓存也上不去)
一个简单判断: 如果你的 NAS 慢是因为“找文件慢、打开目录卡、容器启动慢”,加 SSD 缓存有用;如果是“拷大文件的进度条慢”,加缓存没用,应该看硬盘阵列和网络。
SSD 选型与寿命
拿消费级 SSD 做缓存,最大的顾虑是写入寿命。
- 看 TBW(总写入字节数)和 DWPD(每日全盘写入次数)。 一块 1 TB、TBW 600 的盘,意味着保修期内可写入 600 TB。缓存写入量大的场景,一年吃掉几百 TB 很正常。
- 优先选带 DRAM 缓存的 TLC 盘。 无 DRAM 的廉价盘在持续写入时掉速严重,做缓存会拖累整体性能。
- 避免用 QLC 盘做重写入缓存。 QLC 的写入寿命和持续写入性能都明显低于 TLC。
- 留够余量(Over-provisioning)。 SSD 用到接近满容量时性能和寿命都会下降,缓存盘建议保留 20% 以上空闲空间。
- 监控磨损。 通过 SMART 的“Percentage Used”或“Media Wearout Indicator”跟踪,到 80% 就该考虑更换。
升级前后怎么测
别凭感觉判断“是不是变快了”,用数据说话:
加内存前测: 记录资源监控里的可用内存、swap 使用量、磁盘 IO 等待(iowait)。如果 swap 常年为 0,加内存收益有限。
加内存后测: 重复打开同一个相册或文件夹,对比第二次的加载时间。缓存命中率提升会直接体现在这里。
加 SSD 缓存后测: 缓存需要“预热”才有意义。装上后先正常用几天,让系统把热点数据搬进缓存,再测才准确。刚装完立刻测,缓存还是空的,结论会误导你。
测试方法:
# 顺序读写(大文件场景)
dd if=/dev/zero of=/volume1/test bs=1M count=4096 oflag=direct
dd if=/volume1/test of=/dev/null bs=1M iflag=direct

# 随机读写(小文件场景,更能体现缓存价值)
fio --name=randread --ioengine=libaio --rw=randread --bs=4k
    --numjobs=4 --size=2G --runtime=120 --direct=1 --group_reporting
我的建议顺序
预算有限时,按这个优先级分配:
1. 先把内存加到够用(消除 swap)——这是性价比最高的一步 2. 系统盘换成 SSD(如果系统还跑在机械盘上) 3. 给容器和虚拟机的数据卷配 SSD 4. 最后才考虑读写缓存——它的收益最不确定,最依赖具体使用模式
还有一个经常被忽略的选项:把预算花在硬盘上。四块盘组 RAID 5 的持续带宽远高于两块盘,这种提升是确定的、无条件的,而缓存的收益是看场景的。
最后更新于 2026年9月18日