
NAS 上跑本地 AI:Immich 照片库与大模型,硬件够不够

两类完全不同的”本地 AI”
在 NAS 上谈 AI,实际上是两件事,硬件要求差别巨大:
| 类型 | 代表应用 | 算力需求 | NAS 能否胜任 |
|---|---|---|---|
| 图像理解 | Immich 的照片人脸识别、物体识别、语义搜索 | 中 | ✅ 大多数机型可以 |
| 大语言模型 | Ollama 跑 LLM 对话 | 高 | ⚠️ 多数家用 NAS 勉强 |
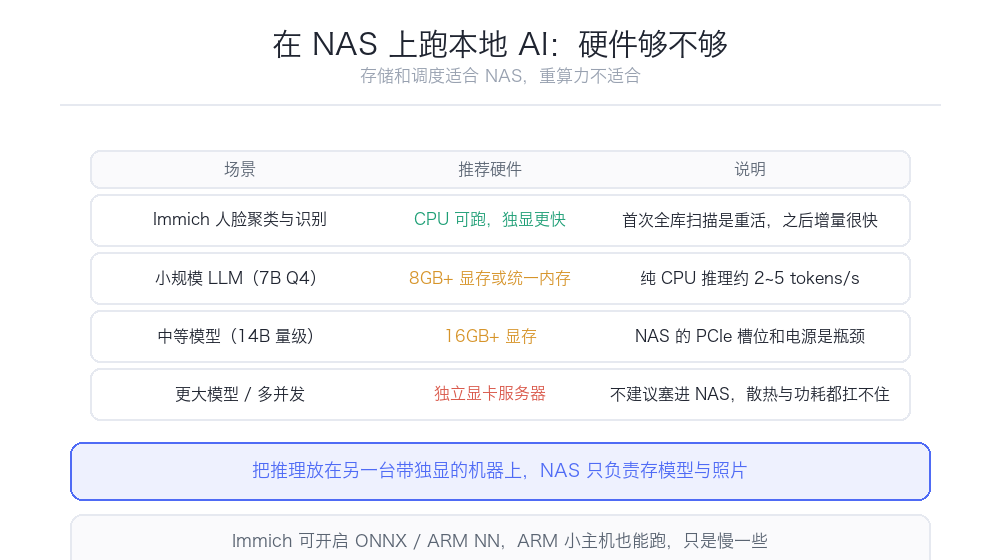
先说结论:图像理解在 NAS 上跑是合理的,大模型通常不应该放在 NAS 上。
Immich:自建照片库
Immich 是目前最活跃的开源照片管理方案,定位是 Google Photos 的自建替代。核心能力:
- 手机自动备份(iOS/Android 客户端)
- 人脸识别与人物聚类
- 物体/场景识别
- CLIP 语义搜索(用自然语言搜照片,比如”海边的日落”)
- 时间线、地图、相册共享
- 支持 Live Photo、RAW、HEIC
组件构成
Immich 不是一个容器,而是一组:
| 组件 | 作用 |
|---|---|
immich-server |
主服务(Web + API) |
immich-machine-learning |
机器学习推理服务 |
postgres(含 pgvector) |
数据库 + 向量检索 |
redis |
缓存与队列 |
机器学习是独立容器这一点很关键——它意味着你可以把它部署在另一台有更好算力的机器上,而不必和主服务挤在一起。
硬件需求
机器学习容器的推理负载:
- CPU 推理:能跑,但慢。首次索引一万张照片可能需要数小时到一整天
- GPU 加速:如果有 NVIDIA 独显(CUDA)效果最好
- Intel 核显 / OpenVINO:部分版本支持,能加速
- Coral TPU:对部分模型有支持
内存需求是另一个关键项。Immich 的完整部署(含 PostgreSQL + Redis)在索引照片库时,内存占用会明显上升。建议 4GB 以上内存,8GB 更从容。2GB 内存的入门 NAS 基本跑不动完整套件。
存储:照片库本身的体积取决于你的照片量。几万张手机照片(含原图)通常在 50–200GB。另外 Immich 会生成缩略图和机器学习缓存,额外占用大约原图的 10–20%。
索引过程的现实体验
首次导入大量照片时:
1. 先生成缩略图(CPU 密集) 2. 再进行机器学习推理(人脸检测、CLIP 编码)
这个过程会持续占用 CPU 数小时甚至更久,期间 NAS 的其他服务会明显变慢。建议:
- 首次导入安排在不用机器的时候(比如睡前)
- 分批导入,不要一次性扔十万张进去
- 在设置里可以调整并发数,降低对系统的冲击
索引是一次性的工作,完成之后日常增量(新照片)的开销就小多了。
与成品方案对比
群晖 Photos、绿联 AI 相册、极空间极相册都提供类似功能,且开箱即用。Immich 的优势是功能和隐私:语义搜索更强、数据完全在自己手里、跨平台客户端体验好。代价是要自己部署维护,且升级时偶尔会有数据库迁移需要处理。
如果你的 NAS 自带相册已经够用,不必强上 Immich。 但如果你想要真正的语义搜索(搜”猫”、”海边”、”红色的车”能直接找到照片),Immich 的体验是成品方案里目前少见能匹敌的。
大模型(LLM):为什么不该放 NAS 上
Ollama 让本地跑大模型变得极其简单——几条命令就能拉起一个模型并提供 API。但能不能跑和跑得好不好是两回事。
算力的现实:
| NAS 配置 | 能跑什么 | 实际速度 |
|---|---|---|
| J4125 / N100(无独显) | 1.5B–3B 量化模型 | 每秒几到十几个 token,勉强可用 |
| N305 / i5-1235U(核显) | 7B 量化模型 | 每秒几个 token,很慢 |
| 带 NVIDIA 独显 | 7B–14B | 每秒几十个 token,流畅 |
关键瓶颈是内存带宽和算力。 大模型推理主要是矩阵乘法,CPU 做这个效率极低。家用 NAS 的处理器(赛扬、N 系列)本来就是低功耗设计,跑 LLM 只能说是”能出字”,谈不上体验。
核显(Intel UHD / Iris Xe)帮不上太多。 虽然理论上可以通过某些后端利用核显,但配置复杂、收益有限,远不如一张独显。
更合理的架构
如果你确实想在家跑大模型,更好的做法是:
- 专门一台带独显的机器跑 Ollama(哪怕是二手的台式机加一张 12GB 显存的卡)
- NAS 专注存储和服务,通过网络调用那台机器的 API
- 或者干脆用云端 API(按量付费,成本可能比买显卡更低)
这样分工后,两边都舒服:NAS 继续安静地做存储和 Immich,大模型跑在合适的硬件上。
如果一定要在 NAS 上试
- 从最小模型开始(1.5B 或 3B 的量化版本)
- 明确预期:这是”能用”,不是”好用”
- 注意内存占用——7B 的 4bit 量化模型大约需要 4–6GB 内存,会挤占其他服务
- 留意功耗和发热,持续满载对小型 NAS 的散热是考验
硬件升级的性价比判断
如果你的目标是更好的 AI 体验,加钱的方向应该是:
| 升级项 | 对图像 AI 的帮助 | 对 LLM 的帮助 |
|---|---|---|
| 加内存到 8–16GB | 大(Immich 需要) | 大(模型要装进内存) |
| 换更强 CPU | 中 | 小(还是慢) |
| 加独显 | 大(CUDA 加速) | 决定性 |
| 加 Coral TPU | 中(部分模型) | 无 |
加内存是最普适的投资,对 Immich 和模型加载都有帮助。想要真正的 LLM 体验,独显是绕不过去的。
隐私与功耗的权衡
本地跑 AI 的最大卖点是隐私——照片不出家门,不上传任何云端。这对很多人是核心价值。
代价是:
- 硬件投入(内存、可能的加速卡)
- 电力消耗(机器学习索引期间 CPU 满载,功耗明显上升)
- 维护成本(Immich 升级、模型更新、故障排查)
一个折中思路:把隐私敏感度高的功能(人脸识别、家庭照片)放本地,把通用能力(需要强算力的)用云端 API。这样在隐私和成本之间取得平衡。
实用建议总结
1. 先明确你要哪种 AI — 照片管理用 Immich,对话助手别放 NAS 2. 内存是第一优先级 — 少于 4GB 先考虑加内存 3. 首次索引要有耐心 — 安排在低峰期,分批导入 4. 备份 Immich 的数据库 — 索引结果(人脸聚类、标签)都在 PostgreSQL 里,丢了要重新索引一遍,非常耗时 5. 不要为了 LLM 去买新 NAS — 这个需求用专门的机器解决更划算
