
NAS 硬盘 SMART 监测完全指南:哪些数值真的能预警,哪些只是噪声

SMART 是什么,又不是什么
SMART(Self-Monitoring, Analysis and Reporting Technology)是硬盘固件自带的一套自检机制。它记录硬盘运行过程中的各种计数,并在数值超过厂商设定阈值时报告”失败”。
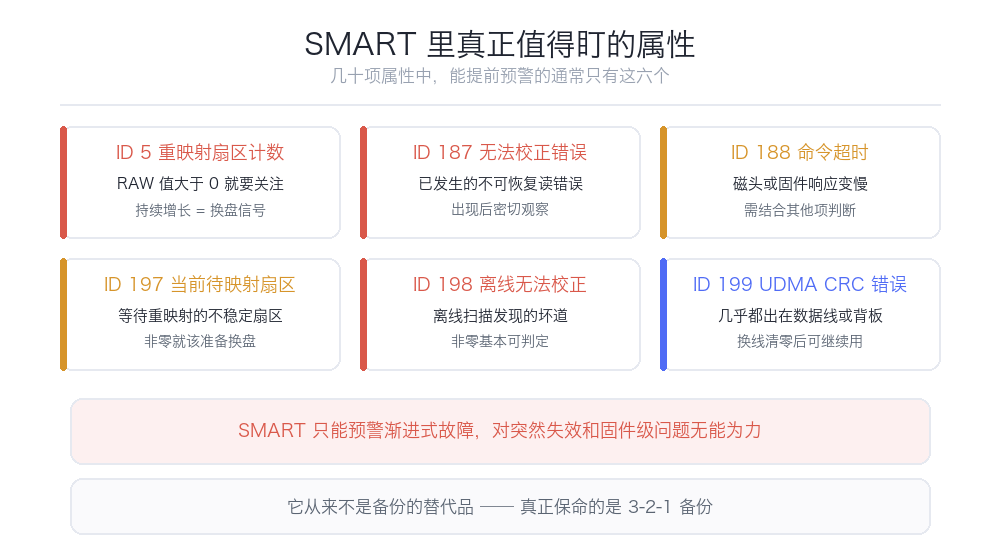
但必须先讲清楚一件事:SMART 是预警系统,不是保险。业界公开的统计里,相当比例的硬盘故障在发生前 SMART 完全正常——盘突然就认不到了。Backblaze 多年来发布的硬盘统计报告反复印证这一点:SMART 能提前预警一部分故障,但绝不是全部。
所以正确的心态是:把 SMART 当作”提前几天到几周换盘的机会窗口”,而不是”数据安全的保障”。真正的安全来自备份。
值得盯的属性
一块盘的 SMART 属性通常有几十项,真正需要关注的只有下面这些:
| ID | 名称 | 含义 | 危险信号 |
|---|---|---|---|
| 5 | Reallocated_Sector_Ct | 已重映射扇区数 | 从 0 变成非 0,或持续增长 |
| 187 | Reported_Uncorrect | 无法校正的错误 | 出现即需警惕 |
| 197 | Current_Pending_Sector | 待重映射扇区 | 非 0 说明有扇区读不出来 |
| 198 | Offline_Uncorrectable | 脱机无法校正扇区 | 非 0 是明确的坏盘征兆 |
| 199 | UDMA_CRC_Error_Count | 数据传输校验错误 | 通常不是盘坏,是线或接口问题 |
| 9 | Power_On_Hours | 累计通电小时 | 判断寿命阶段 |
| 194 | Temperature_Celsius | 温度 | 长期超过 45℃ 需改善散热 |
看 RAW 值,不要只看归一化值。 很多系统界面只显示”当前值/最差值/阈值”这三列 100→0 的归一化数字,但真正有诊断价值的是最后一列 RAW_VALUE。比如 ID 5 的 RAW 值直接就是重映射的扇区数量,从 0 变 1 和从 1 变 100 是完全不同的严重程度。
趋势比绝对值重要。 一次快照看不出什么。真正有价值的做法是把每次巡检的 RAW 值记下来,看增长曲线。一个稳定在 8 的重映射计数不可怕,一周内从 8 涨到 80 才可怕。
三个最容易误判的点
199 UDMA CRC 错误不是硬盘坏了。 这个计数反映的是硬盘与控制器之间的数据传输校验失败,绝大多数情况是 SATA 线松动、劣化,或者背板接触不良。处理方式:换线、重新插拔、换口,然后看计数是否停止增长。如果换了线还涨,再怀疑盘。
通电时间不等于磨损。 机械盘的寿命和通电小时数相关,但不是线性关系。一块 7×24 运行三年(约 26000 小时)的盘,和一块每天开关机、三年累计 8000 小时的盘,后者未必更健康——频繁启停带来的机械应力同样消耗寿命。
温度是最容易被忽视的一项。 长期高温会加速所有老化过程。一般建议把 NAS 硬盘控制在 35–45℃ 区间,超过 50℃ 就应该认真查散热了。注意官方规格里的工作温度通常到 60℃,那是”能跑”的上限,不是”该跑”的目标。
用 smartctl 做手工检查
在 Linux(包括绝大多数 NAS 的 SSH 终端)上,工具是 smartctl:
# 看硬盘信息,确认是否支持 SMART
smartctl -i /dev/sda

# 健康总览,只看结论
smartctl -H /dev/sda

# 完整属性表,重点看 RAW_VALUE 列
smartctl -A /dev/sda

# 启动短测试(通常几分钟)
smartctl -t short /dev/sda

# 启动长测试(大容量盘可能要几个小时)
smartctl -t long /dev/sda

# 查看测试结果与错误日志
smartctl -l selftest /dev/sda
smartctl -l error /dev/sda
需要注意,测试是异步的:发起后硬盘在后台跑,你过一段时间再用 -l selftest 看结果。长测试期间硬盘仍可正常服务,只是性能会受影响,建议安排在业务低峰。
对 NVMe 固态,SMART 的语义不同,属性也换了一套,smartctl -A /dev/nvme0 会显示可用空间百分比、数据写入量、通电时间等。固态最值得关注的是已写入数据总量(TBW 占比)和可用备用块百分比。
自动化:让系统替你盯
smartd(smartmontools 自带的守护进程)是最通用的方案。它按配置周期性检查,发现异常时执行指定动作(通常是发邮件):
# Debian / Ubuntu
sudo apt install smartmontools

# 主配置文件
/etc/smartd.conf
一条典型配置会在检测到属性变化时告警,并安排每月的长测试。具体参数写法建议直接查 man smartd.conf,不同发行版和版本的细节有差异。
成品 NAS 系统基本都内置了这一层,只是入口不同:
- 群晖 DSM:存储管理器 → 硬盘 → 健康状况,可设置定期 S.M.A.R.T. 测试计划
- 威联通 QTS:存储与快照总管 → 磁盘健康
- 绿联 UGOS Pro、极空间 ZOS、铁威马 TOS:在存储管理或硬盘信息里都有对应的健康页与测试按钮
- TrueNAS:Web 界面可以设置 S.M.A.R.T. 测试计划,并在异常时发邮件
无论用哪种系统,都建议做两件事:开启每月一次的扩展(长)测试,以及配置告警通知(邮件或系统通知)。没有告警的巡检等于没巡检——你不会记得每月手动去看。
什么时候该换盘
给出一套可执行的判断标准:
| 情况 | 处理建议 |
|---|---|
| 重映射扇区(ID 5)持续增加 | 尽快换,不要等 |
| 待映射扇区(ID 197)出现 | 立即换,这是读不出来的扇区 |
| 脱机无法校正(ID 198)非 0 | 立即换 |
| UDMA CRC(ID 199)增长 | 先换数据线和接口,无效再换盘 |
| 温度长期高于 50℃ | 先解决散热,盘本身可能还健康 |
| 只有通电时间长,其余正常 | 继续用,但提高巡检频率 |
换盘前记得先确认阵列里还有冗余余量。RAID 5 在降级状态下换盘,重建过程本身是有风险的——这也是为什么现在普遍建议大容量阵列用 RAID 6 或者双校验方案。
最后的提醒
再强调一次:SMART 告诉你的是”这块盘可能快不行了”,它不会告诉你”你的数据是安全的”。任何基于 SMART 的安心感都是错觉。真正让你睡得着觉的是一份独立的、最好异地的备份。
